Hugging Face Journal Club: Scaling Laws for Pre-training & RL
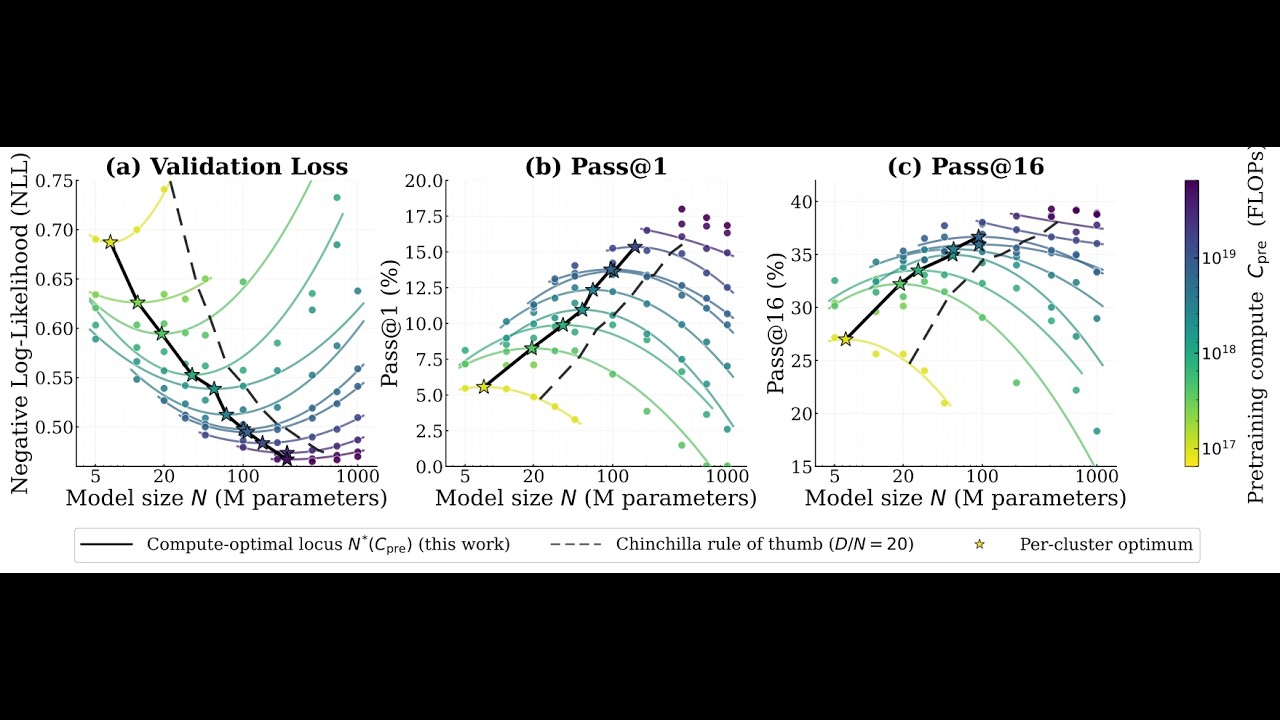
The research team discusses a joint scaling law for pre-training and RL, showing how compute allocation across these stages impacts downstream task performance. Key findings relate to optimizing model size versus training duration.
Read article